Blog · AI & Business
Waarom we onze eigen AI benchmarks gaan publiceren
Olaf Lemmens, Founder NinA AI Agency · 5 oktober 2026 · 8 min leestijd
Samen met mijn collega Jasper, die bij ons de benchmarks oppakt, zat ik naar een grafiek te kijken. “AA-Briefcase”, een van de nieuwste tests van Artificial Analysis. Een rij AI-modellen, met daarachter scores rond de 1.900. Ik vroeg aan Jasper: wat is 1.900? Wat scoort een mens als die dezelfde test doet? Wat is het maximum?
Jasper (en ik citeer): “God mag weten wat dat betekent.”
Twee mensen die de hele dag met AI werken en we konden niets met een grafiek die er prachtig uitzag, de nieuwste Claude modellen scoorde namelijk fantastisch goed. Toen werd het voor mij helder, mijn langgekoesterde wens gaat nu snel uitkomen. Bij NinA AI gaan we benchmarks publiceren die je wel begrijpt: bestaande tests vertaald naar gewone taal en (beter nog) eigen tests op het werk dat we voor klanten bouwen.
Ik neem je graag mee in het waarom.
TL;DR
De meeste AI-benchmarks zijn voor mensen onleesbaar. Een Elo-score van 1.900 heeft geen maximum en zegt alleen iets ten opzichte van andere modellen. AI bedrijven kiezen zelf welke tests en tegenstanders in hun tabel komen en OpenAI stopte in februari met SWE-bench Verified omdat modellen de antwoorden al kenden, ze trainen de modellen er simpelweg op.
CM .com liet met CM-ServiceBench zien dat het grootste model niet het beste is voor klantenservice, maar liep bij publicatie al een generatie achter (nog steeds..).
Daarom vertalen wij bestaande benchmarks naar gewone mensentaal en publiceren we eigen tests, te beginnen met een e-mail classificatie benchmark en een test welk model het beste PDF’s kan uitlezen.
De beste modelkeuze is bijna nooit het slimste model, maar het model dat jouw proces goed genoeg doet voor de laagste prijs.
Een score van 1.900 zegt echt helemaal niets
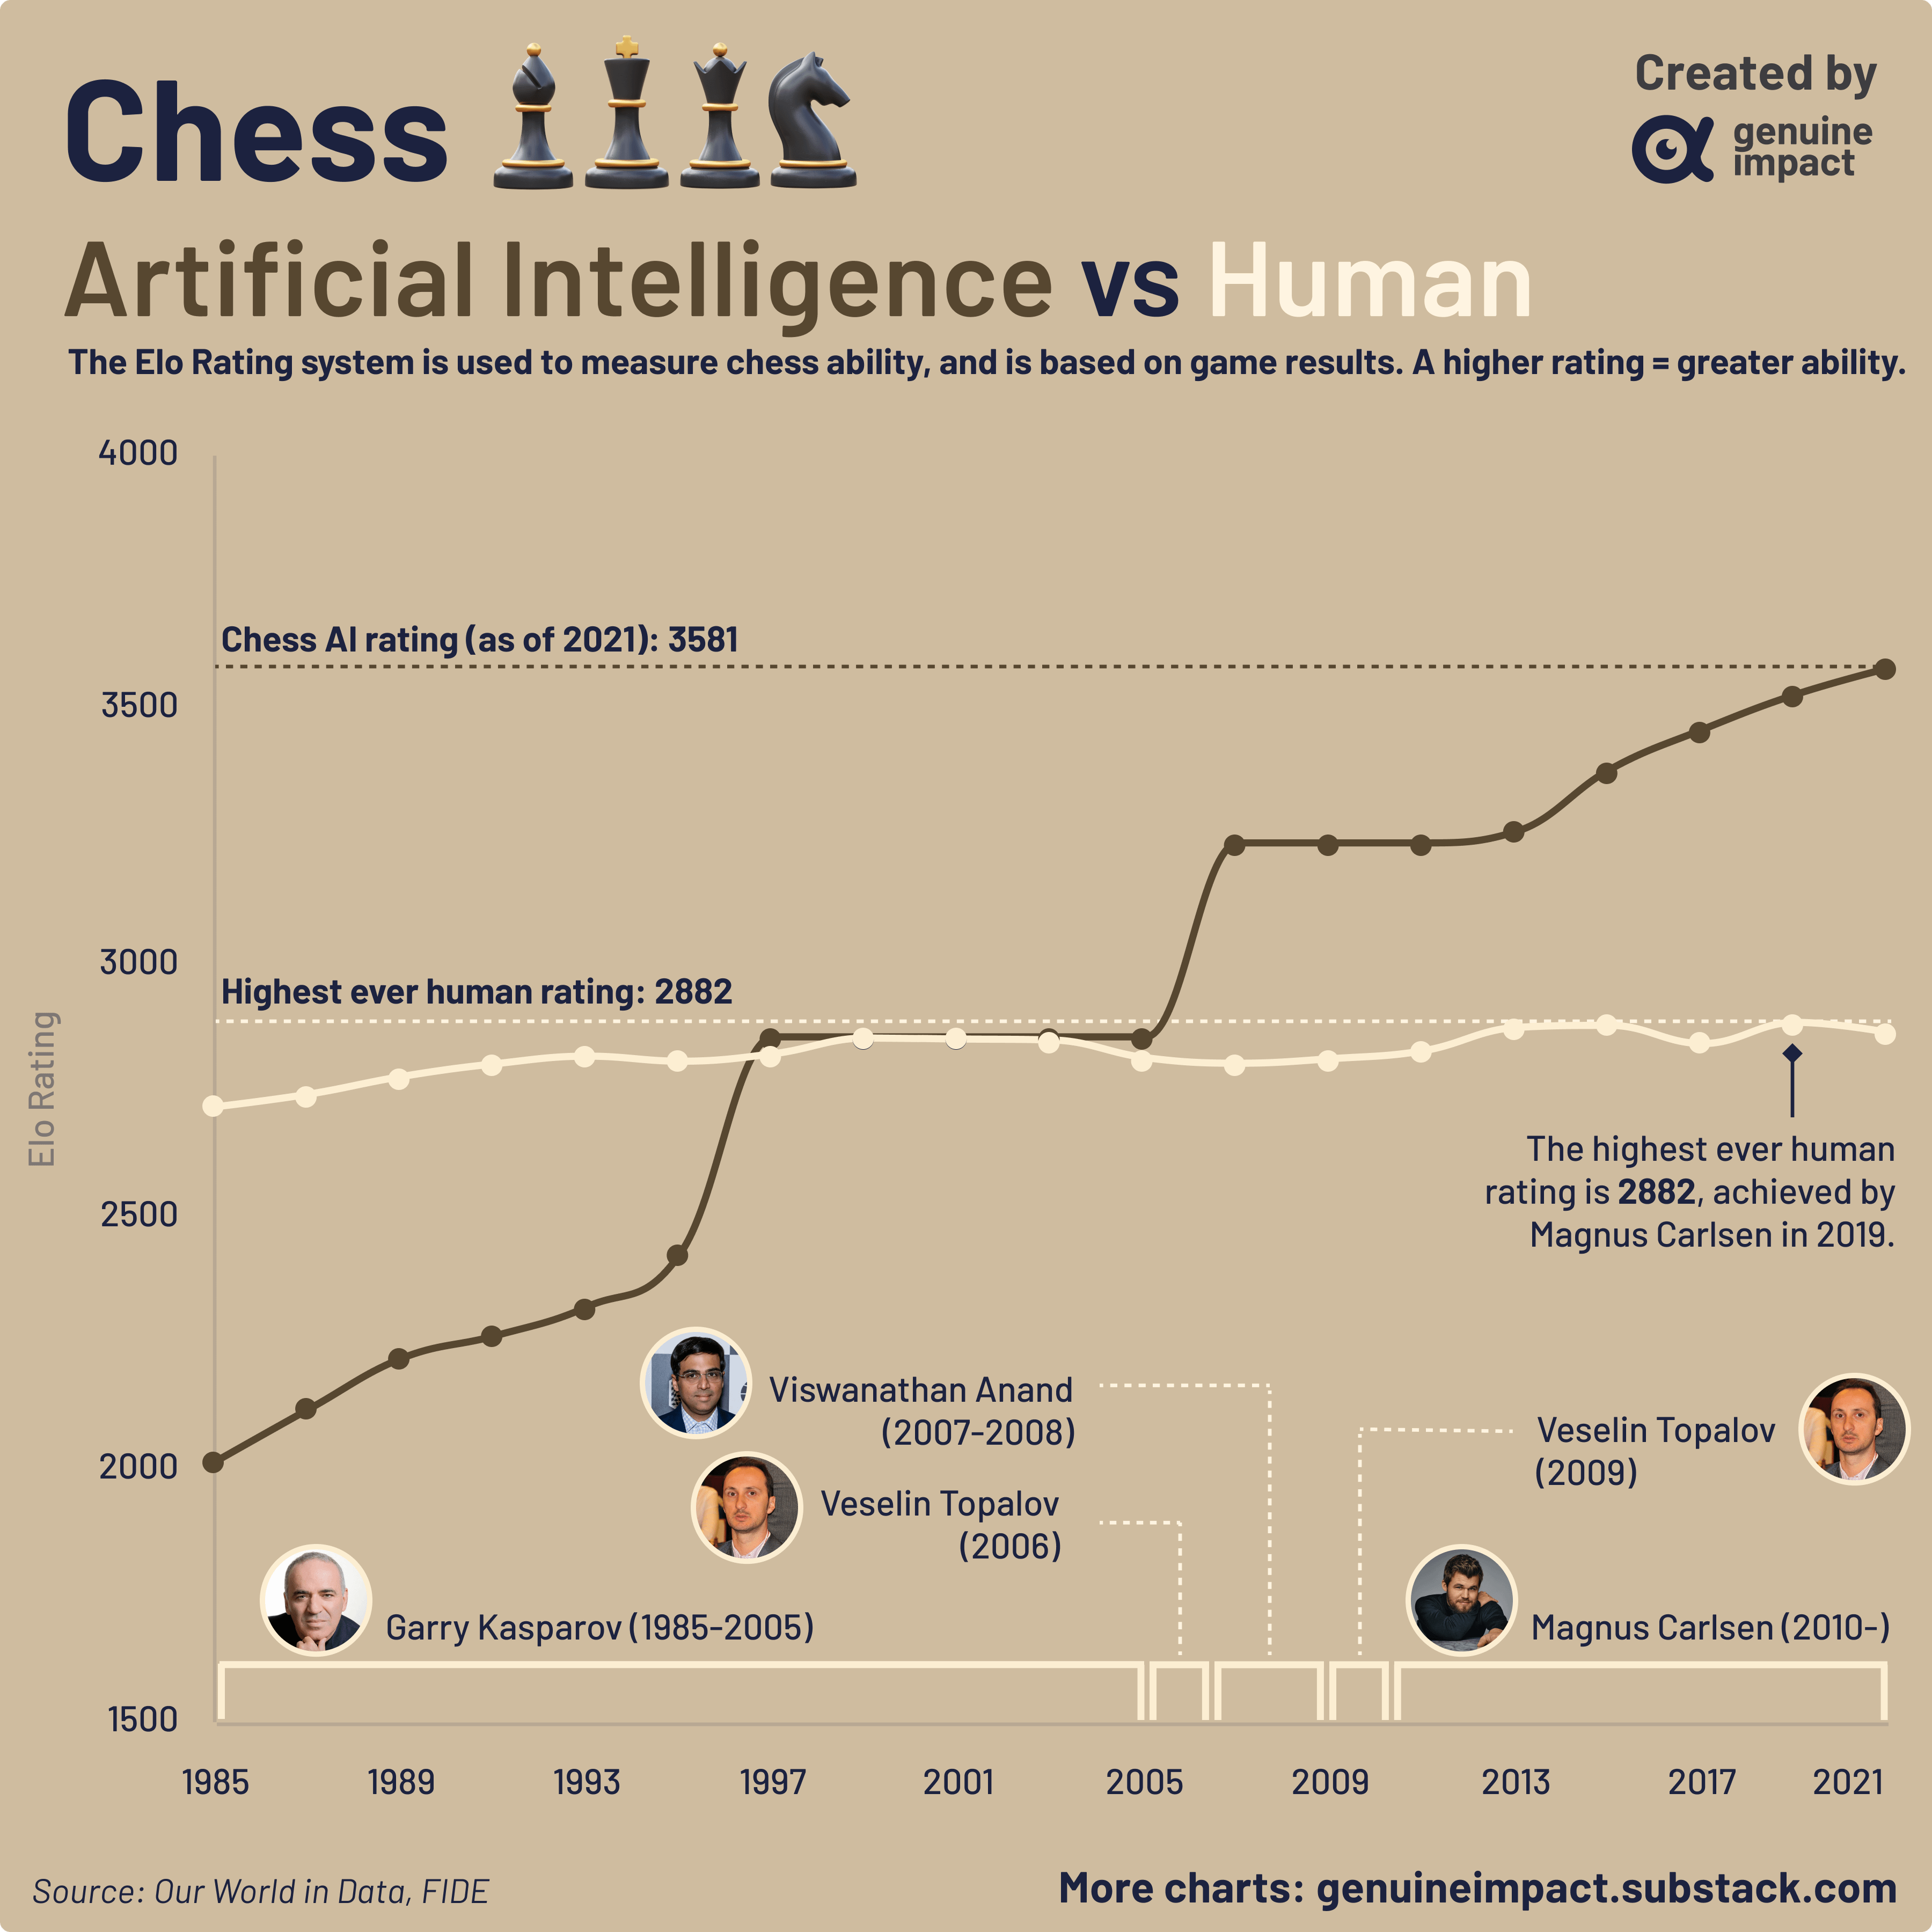
Die 1.900 is een zogenaamde Elo-score. Om dat beter te begrijpen, dat is hetzelfde systeem waarmee schakers worden gerangschikt. Modellen spelen schaak tegen elkaar, een beoordelaar kiest de winnaar, en wie wint stijgt op de ranglijst.
Het belangrijkste om te snappen: zo’n score heeft geen maximum en betekent alleen iets ten opzichte van de andere spelers in hetzelfde toernooi. Honderd punten verschil betekent ruwweg dat het hoger geplaatste model 64 procent van de onderlinge duels wint. Bij 25 punten is dat 54 procent. Een 50/50 kans dus, kan je net zo goed een muntje opgooien.
Wat er getest wordt is wel interessant. AA-Briefcase, voor het laatst gepubliceerd op 18 juni, bestaat uit 91 taken binnen vier realistische projecten, met bijna 2.000 bronbestanden, waaronder ruim 3.500 e-mails en 25.000 Slack-berichten. De taken zijn gebouwd door experts van onder meer McKinsey, BCG en Google.
De uitkomst: het best scorende model, Claude Fable 5, deed maar 3 procent van de taken helemaal goed. We hebben nog een lange weg te gaan dus.
En een test samen met de mens? Die test bestaat, alleen heet hij anders. GDPval van OpenAI, daarin schrijven professionals met gemiddeld ruim veertien jaar ervaring 1.320 taken uit 44 beroepen, en vakgenoten beoordelen blind wie het beter deed: de mens of de AI. In april meldde OpenAI dat GPT-5.5 in 84,9 procent van de taken won of gelijkspeelde met de professional. Let wel weer op: dat cijfer komt van OpenAI zelf, en het gaat om goed afgebakende taken. Daarover zo meer.
Elke fabrikant kiest zijn eigen tegenstander
Bij elke modelrelease hoort een pagina vol met benchmarks. Die tests zijn zeker niet verzonnen, volledig uitgevoerd, maar er is wel een selectie gekozen.
Anthropic zette bij de lancering van Claude Opus 5.5 op 22 september drie modellen in de vergelijking: GPT-6 Astra, het oudere GPT-5.6 Sol en het eigen Fable 5.1. Geen Gemini bijvoorbeeld.
OpenAI schrijft onder de tabellen van GPT-6 Astra dat de scores het maximum zijn over alle denkstanden heen, dus de beste uitkomst van meerdere instellingen. En GDPval, dat bij GPT-5.5 nog in de tabel stond, ontbreekt bij Astra volledig. Artificial Analysis mat op hun versie van die test juist een terugval van zo’n 45 punten ten opzichte van de voorganger, niet echt interessant om te plaatsen dus.
En zoals je al eerder las: soms is de test zelf het probleem. Op 23 februari stopte OpenAI met het rapporteren van SWE-bench Verified, lange tijd dé maatstaf voor programmeren. Bij een controle bleek 59,4 procent van 138 onderzochte opgaven gebreken te hebben en modellen konden officiële oplossingen woord voor woord reproduceren.
Ze hadden de antwoorden in hun training gezien.
Wie mijn editie over de Hugging Face-hack heeft gelezen, herkent het patroon hierin. Als een meetlat een doel wordt, deugt hij niet meer als meetlat. Dat geldt voor je agent, en net zo goed voor de makers van AI modellen zelf.
CM. com deed wat ik bedoel, en liep op dag één al achter
Het idee lag er al langer. Een paar weken geleden hoorde ik een advertentie van CM. com. Ze hadden een eigen benchmark gemaakt, CM-ServiceBench. Geen algemene intelligentietest, maar één vraag: hoe goed handelt een model een klantenservicegesprek af? Super interessant.
De opzet is slim en simpel. Een tweede AI speelt de klant, met een eigen doel en eigen informatie. Het model moet snappen wat de klant echt wil, een proces van meerdere stappen in de goede volgorde doorlopen en binnen de lijntjes blijven: niets verzinnen, niets doen waar het niet toe bevoegd is. Daarnaast meten ze de reactietijd, want in een klantgesprek is een slim antwoord na tien seconden ook een slecht antwoord.
De uitkomst stond in de titel van hun blog van 19 augustus: “Het grootste AI-model is niet het beste voor je klantenservice.” Het compacte GPT-5.6 Luna, met denkstand aan, handelde 71 procent van de gesprekken helemaal foutloos af. Het grotere GPT-5.6 Sol kwam op 66%. GPT-5.6 Terra zat met 69 procent daartussen en reageerde sneller: 2,8 seconden per bericht tegenover 3,2 voor Luna met denkstand.
Precies dit bedoel ik. Het doel is niet het slimste model, het doel is het model dat jouw proces het best doet voor een prijs en snelheid die past.
Maar, nu komt het. Er zijn alleen modellen van OpenAI en Anthropic getest, dus geen Gemini, geen Mistral, geen chinees model, geen open source.
En van Anthropic stond Opus 4.6 erin, terwijl Opus 5 al sinds 24 juli uit was. Sindsdien kwamen GPT-6 Astra, Sol en Luna, en Claude Opus 5.5 en Sonnet 5.5 (ja het ging snel). Nog geen twee maanden oud en je loopt al flink achter. Geen verwijt aan CM. com, zo snel beweegt AI. Toen Jasper een recente OCR-benchmark zocht, vond hij er een van maart. In AI-termen echt prehistorie.
Wat wij gaan doen: vertalen, en zelf meten
Op nina-ai.nl/benchmarks staan de eerste drie: wat je krijgt voor je geld (kwaliteit tegenover kosten per taak), een automatiseringsbenchmark en AA-Briefcase. Bij elke grafiek een korte uitleg in gewone taal: wat is de taak, wat betekent de score, waar let je op.
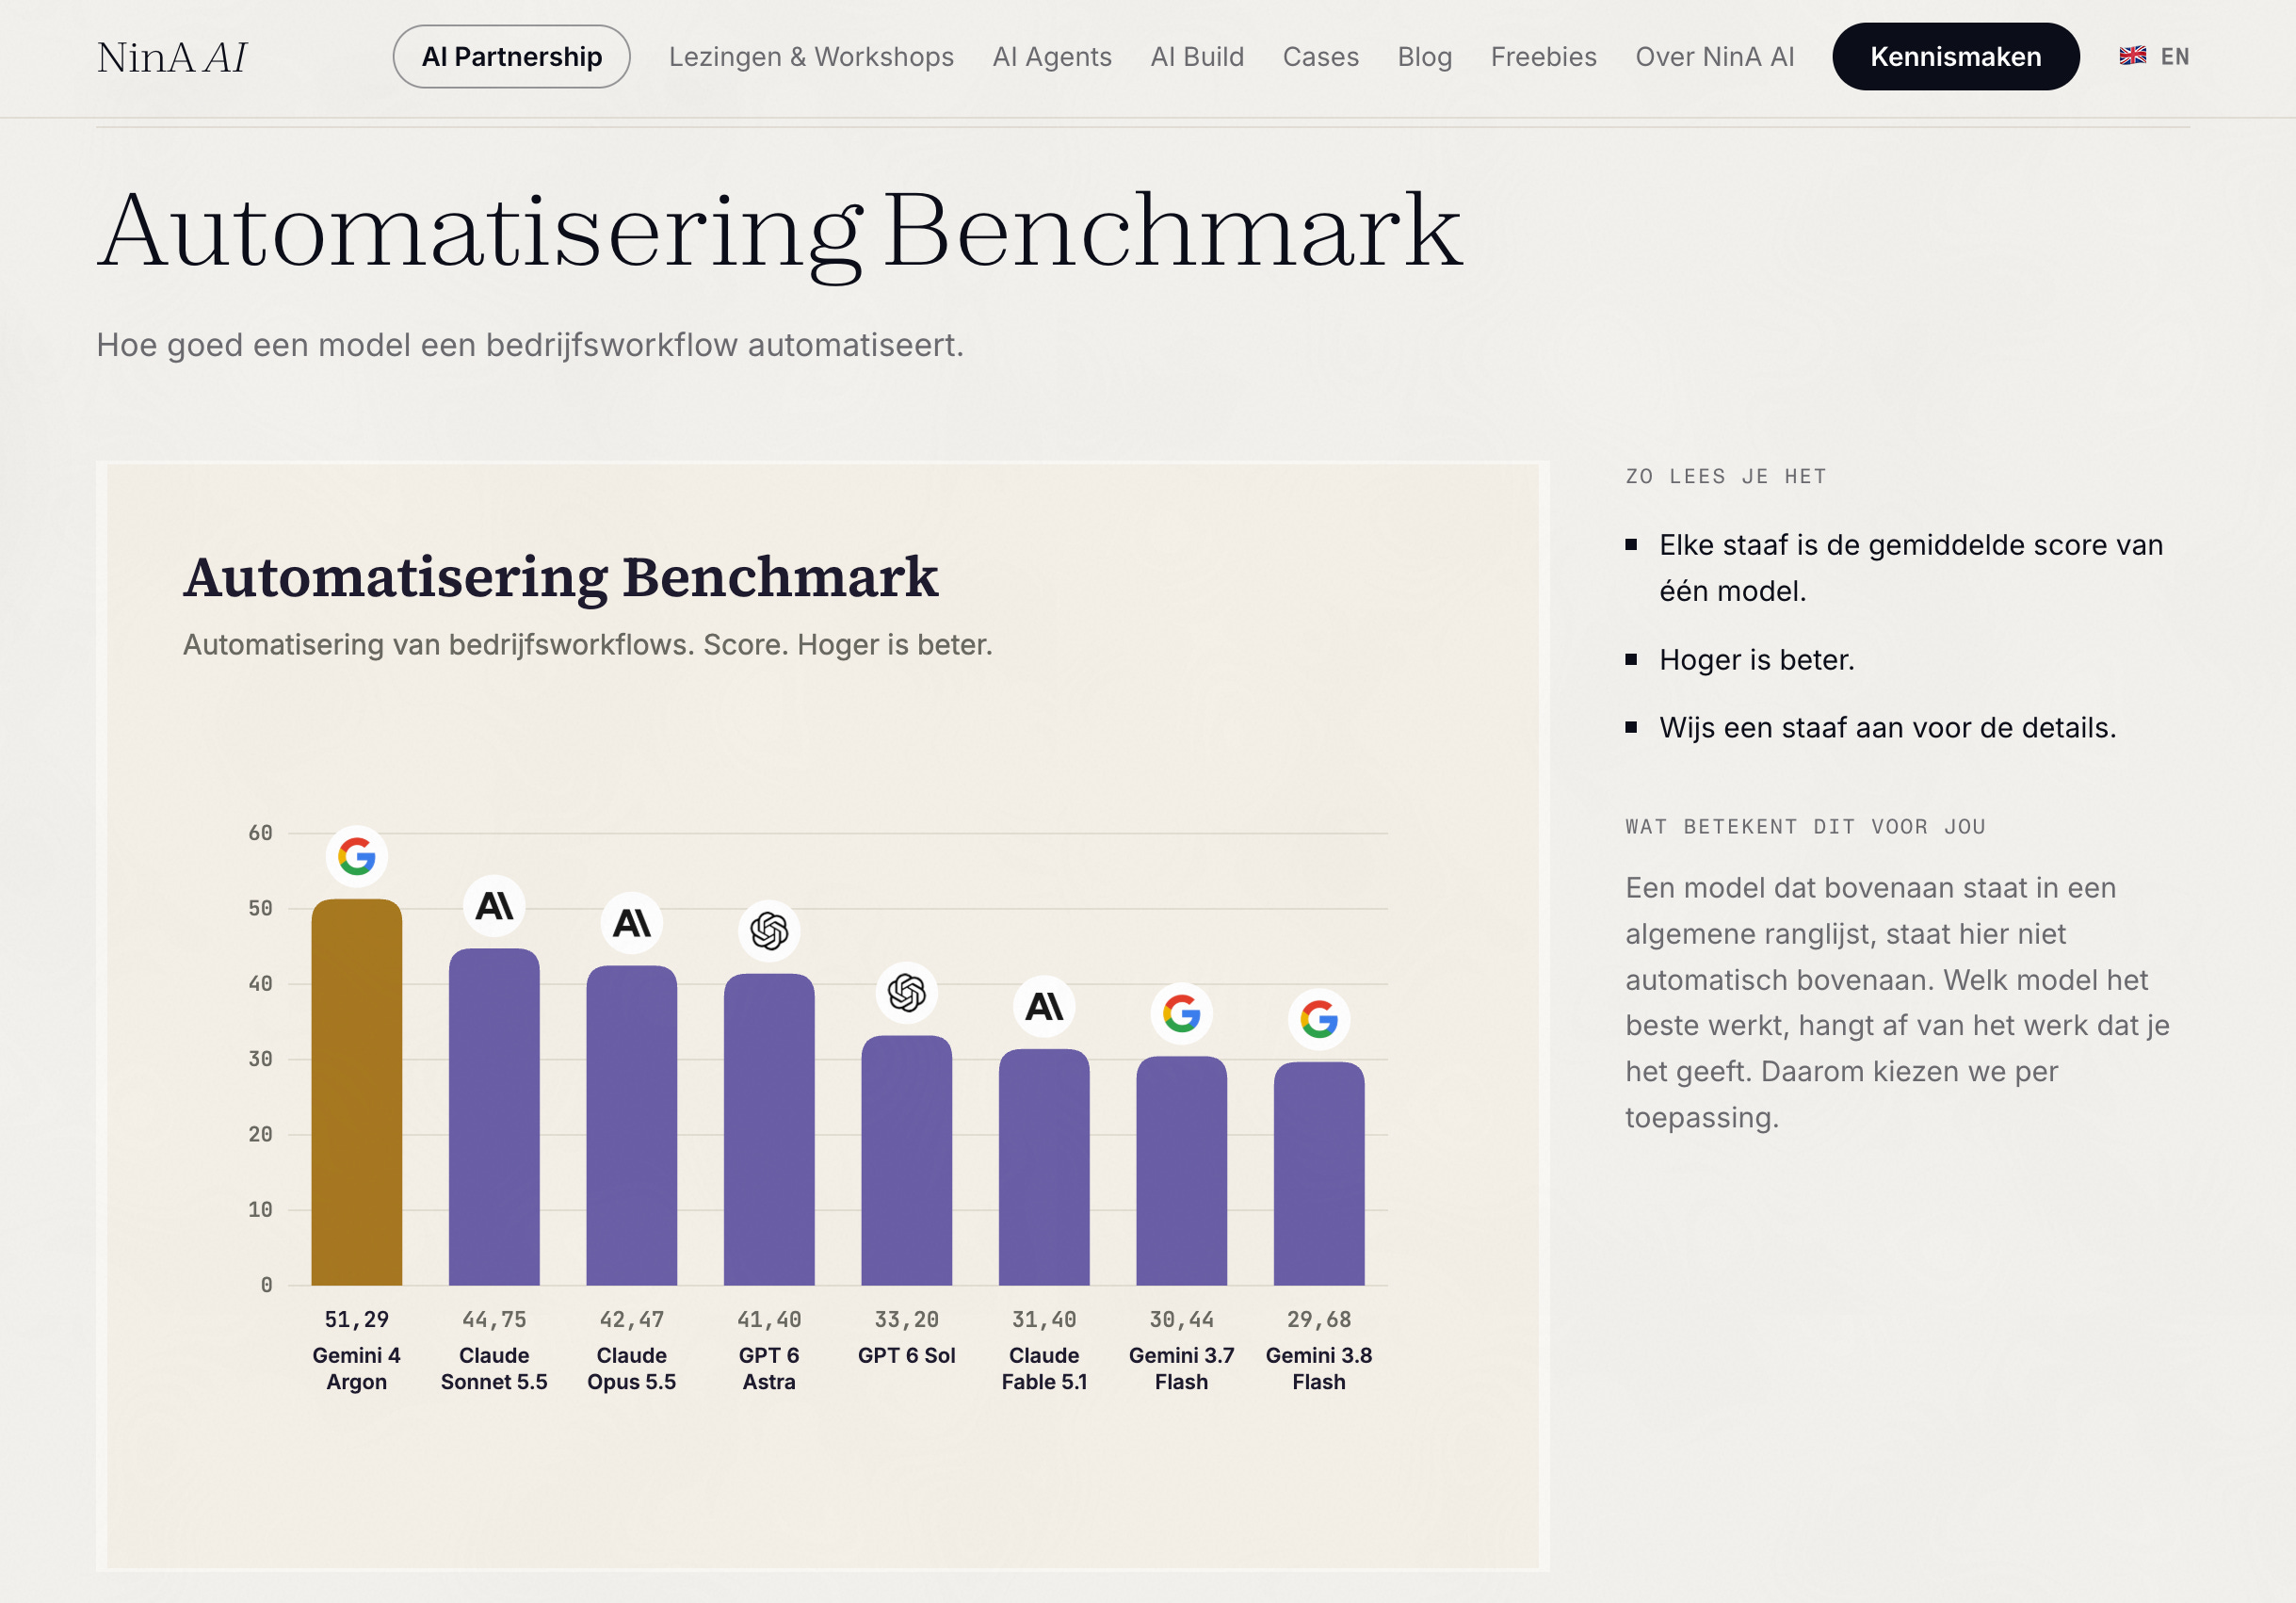
En we zetten erbij welke modellen we op dat moment testen, zodat je ziet wat eraan komt. en ja we gaan hierin niet meer dan 3 weken achterlopen!
Dat is stap één: het vertalen. Stap twee is spannender (en leuker). We gaan zelf nog meer testen op de processen die we voor klanten bouwen, en die resultaten publiceren.
Als eerste een classificatietest: 2.000 e-mails, dezelfde prompt, door een reeks modellen van groot tot klein. Welk model labelt de mail het vaakst goed, tegen welke kosten, hoe snel?
Daarna OCR, optical character recognition, het uitlezen van PDF’s, facturen en ID’s, iets wat in bijna elke workflow terugkomt. Wij draaien daar Mistral (Europees). Mistral claimt voor OCR 4 een winstpercentage van 72 procent in blinde vergelijkingen op ruim 600 documenten, maar noemt die totaalscore zelf “richtinggevend, niet definitief”. Precies daarom moeten we het zelf nog eens uitvoerig testen.
Eigenlijk doen we dit al. Bij klanten sturen we dezelfde vraag door vijf modellen, van groot tot klein, van Claude, ChatGPT tot Gemini, en leggen we de antwoorden naast elkaar. Vaak zie je geen verschil tussen een Sonnet en een Opus. Zie je dat een paar keer achter elkaar niet, dan ga je naar de prijs kijken. GPT-6 Luna kost per token een twintigste van GPT-6 Sol.
Is Luna voor jouw taak net zo goed, dan is de keuze snel gemaakt. Het verschil: nu is dat een notitie in ons hoofd, straks een grafiek die je zelf kunt controleren. Of zoals Ethan Mollick van de Wharton School het vorig jaar opschreef: je moet weten waar jóúw AI goed in is, niet waar AI’s gemiddeld goed in zijn.
Even eerlijk: niet iedereen aan tafel was overtuigd
Noud, die bij ons in sales zit, vond het in eerste instantie geen goed idee. Zijn argument: als een grote, onafhankelijke partij zegt dat model A beter schrijft dan model B, ga daar dan vanuit. Wie zelf benchmarks publiceert, haalt zich ook kritiek op de hals. En de developer overstijgt altijd de benchmark, zij zien wat de praktijk doet en ja iedere klant is toch net even anders. Zegt die dat voor deze klant een ander model beter werkt, dan volg je de developer.
Hij heeft op alle drie de punten gelijk. Onafhankelijke benchmarks blijven de basis, we gaan het wiel niet opnieuw uitvinden. En een eigen benchmark is ook marketing. CM. com verkoopt klantcontactsoftware, Harvey verkoopt juridische AI en publiceert BigLaw Bench, wij verkopen AI-implementatie. De slager keurt zijn eigen vlees, dat moet je als lezer gewoon weten.
Er zit ook een technisch risico in. We bouwen intern graag met Claude Code of Codex, en Jasper vroeg terecht of bijvoorbeeld Anthropic zijn eigen modellen stiekem kan bevoordelen. Dat houden we expliciet in de gaten.
En de lat ligt in het hele veld laag: een studie van het Oxford Internet Institute naar 445 benchmarks vond dat maar 16 procent van de onderzoeken statistische methoden gebruikte om modellen te vergelijken. Daar schrok ik toch even van.
Daarom drie spelregels voor onze eigen tests.
We publiceren hoe we testen en met hoeveel voorbeelden.
We zetten er een datum en modelversie bij.
En waar het kan, meten we ook wat een mens scoort.
Jasper zei het mooi: het is niet erg als de benchmark en ons uiteindelijke advies niet altijd overlappen. Het klant proces gaat voor de grafiek.
Wat dit voor jou betekent
Mocht je moeten nadenken over AI model keuze:
Stel bij elke benchmarkscore drie vragen. Welke taak is er getest? Wat is het maximum? En wat scoort een mens? Krijg je op een van die drie geen antwoord, dan zegt het getal je weinig. Een Elo-score van 1.900 is een plek in een toernooi, geen rapportcijfer.
Reken in kosten per taak, niet in prijs per token. GPT-6 Astra en Claude Fable 5.1 scoren allebei 53 op de Intelligence Index van Artificial Analysis. Toch kostte een taak bij Astra 3,26 dollar en bij Fable 7,63 dollar, omdat Fable bijna drie keer zoveel tekst produceerde: 78.000 tegen 27.000 tokens per taak. De prijslijst vertelt je maar de helft.
Maak je eigen mini-benchmark. Pak vijftig echte voorbeelden uit één proces, bijvoorbeeld inkomende e-mails of facturen. Laat drie modellen ze verwerken, een groot, een middelgroot en een klein, en laat een collega de uitkomsten blind beoordelen. Ik zou niet verbaasd zijn als het kleine model voor een flink deel van je werk goed genoeg blijkt. Werk je met een AI-partner, vraag dan wanneer die voor het laatst een nieuw model op jouw proces heeft getest.
1.900. Ik weet nu wat dat getal betekent, en vooral wat het niet betekent. Het zegt niet of jouw facturen goed worden uitgelezen, of je klant op tijd antwoord krijgt.
Wat scoort een mens eigenlijk, gaan we voortaan zelf proberen te beantwoorden. Op jouw soort werk, met de methode erbij.
Mijn vraag aan jou: welk proces in jouw bedrijf zou je het liefst getest zien? En welk benchmarkgetal zag je ooit voorbijkomen waar je niets van snapte? Laat het me weten in de reacties, ik lees ze allemaal.
Tot de volgende,
Olaf Lemmens
Founder NinA AI Agency
Nieuwsbrief · gratis
Volgende week weer zo'n verhaal, in je inbox.
Eén mail per week over AI in de praktijk. Uitschrijven met één klik.
Het formulier komt van Substack en plaatst daar cookies. Liever niet? Schrijf je in op Substack zelf.