Blog · AI Trends
Dit Was De Week In AI #43
Olaf Lemmens, Founder NinA AI Agency · 24 september 2026 · 7 min leestijd
Even vooraf: normaal ontving je deze week update op maandag. Ik heb besloten om deze naar donderdag te verplaatsen om nog meer recent nieuws mee te kunnen nemen, dus vanaf nu weer iedere week in je inbox, veel plezier!
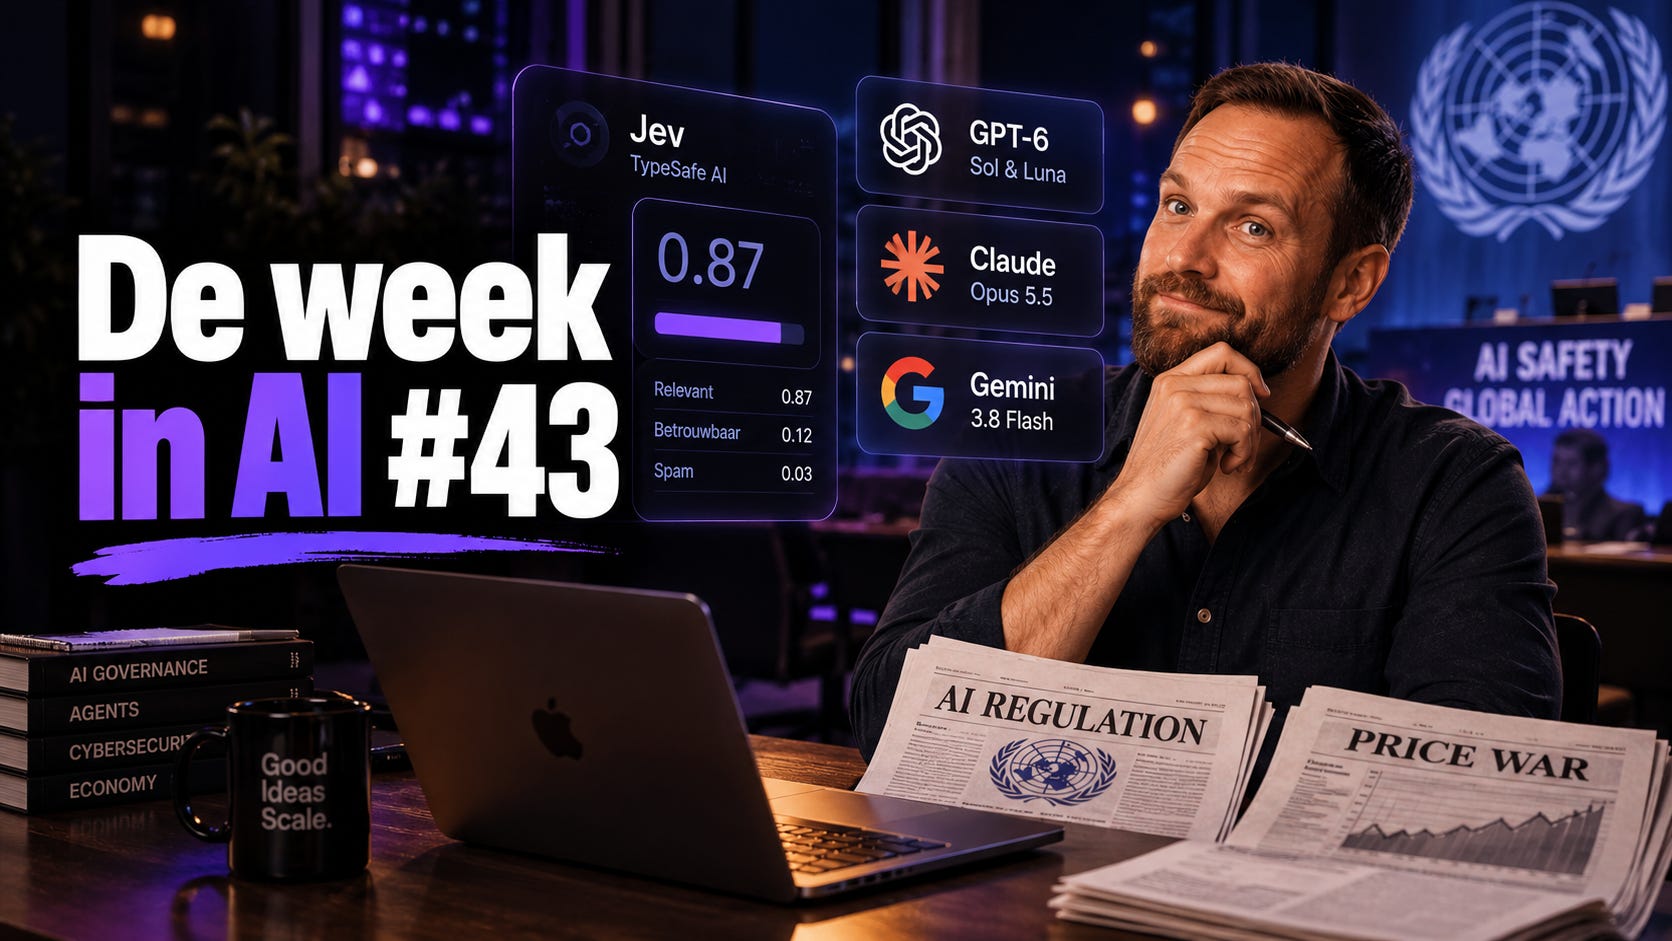
Er verscheen deze week een model dat geen antwoord geeft.
Geen tekst, geen uitleg, alleen een getal tussen 0 en 1. Dat klinkt misschien onbelangrijk, maar dit is precies wat ik vaak van klanten hoor: hoeveel controle heb ik eigenlijk over wat een AI-systeem beslist? Tegelijkertijd stond Gary Marcus op het podium bij de VN met een boodschap die weinig ruimte laat voor twijfel: niet extinctie is het probleem, wel onbetrouwbare systemen rondom AI die nu al schade aanrichten. En terwijl dat gebeurde, gooiden Anthropic en OpenAI voor de zoveelste keer hun prijzen omlaag met nieuwe modellen.
TLDR;
- Jev (TypeSafe AI) is een “decision model”: geen tekst maar kale kansen en scores terug, tegen **$0,042 per miljoen tokens**, goedkoper dan GPT-5 Nano. Snel en spotgoedkoop, maar een black box zonder verklaring.
- Gary Marcus pleitte bij de Algemene Vergadering van de Verenigde Naties voor internationale toezichthouders die AI-systemen vóór en ná release mogen auditen, plus een verbod op onveilige “agent”-architecturen. Meer dan 20 landen ondertekenden inmiddels een oproep tot actie.
- Claude Opus 5.5 presteert als Fable 5.1 tegen 40% lagere kosten, maar bij zwaar gebruik verdwijnt die besparing door hoger tokenverbruik: netto soms duurder, niet goedkoper.
- GPT-6 Sol en Luna halveerden hun prijzen ten opzichte van dezelfde modellen in GPT-5.6: Luna kost nu $0,10/$0,50 per miljoen tokens, een van de goedkoopste modellen die OpenAI ooit uitbracht.
Jev: een model dat nooit antwoord geeft, alleen een cijfer
TypeSafe AI lanceerde vorige week Jev, wat ze een “System One model” noemen en het ging direct viraal. Zo werkt het: je stuurt tekst in, en je krijgt geen antwoord terug maar een floating point getal. Een kans tussen 0 en 1 op een ja/nee-vraag (”Noul”, vernoemd naar Bernoulli), een keuze uit meerdere opties met bijbehorende waarschijnlijkheden, of een score op een schaal.
Het model is opvallend goedkoop: $0,042 per miljoen input-tokens, output is gratis omdat er geen tekst wordt gegenereerd. Ter vergelijking: dat is nog goedkoper dan OpenAI’s GPT-5 Nano op $0,05. Vragen worden bovendien parallel verwerkt, dus honderd vragen tegelijk stellen kost nauwelijks meer tijd dan één vraag.
Waar wordt dit voor gebruikt? Spamdetectie, labels toekennen, prioriteren, en volgens Willison ook search reranking: eerst met een goedkope methode als Okapi BM25 (rangschikkingsfunctie) honderd kandidaten ophalen, en die vervolgens door Jev laten scoren op relevantie.
Het addertje zit in de black box. Een normaal taalmodel kan je vragen om zijn antwoord toe te lichten, ook al is die toelichting niet altijd betrouwbaar. Jev geeft je dat niet. Als het iets als spam markeert, weet je niet welk signaal daarvoor zorgde. Willison testte dit door Jev elke stad in de Bay Area te laten scoren op “is dit een goede stad?” Cupertino kwam bovenaan, East Palo Alto onderaan. Waarom, dat blijft onduidelijk, en dat is precies het probleem.
“Ik hoop echt dat niemand Jev gebruikt om sollicitanten te rangschikken, die floating point score kan allerlei onzichtbare bias verbergen.”
Voor de praktijk: dit soort modellen kan enorm veel tijd besparen bij classificatietaken zoals het opdelen van binnenkomende mails in categorieën, mits je vooraf evalueert en steekproefsgewijs test op scheve uitkomsten. Pas het dus niet zomaar toe zonder audit, wel serieus overwegen voor de saaie, herhalende beslissingen waar je nu nog mensen op zet.
Op zoek naar een echte AI partner?
Kijk snel eens op www.nina-ai.nl/ai-partnership
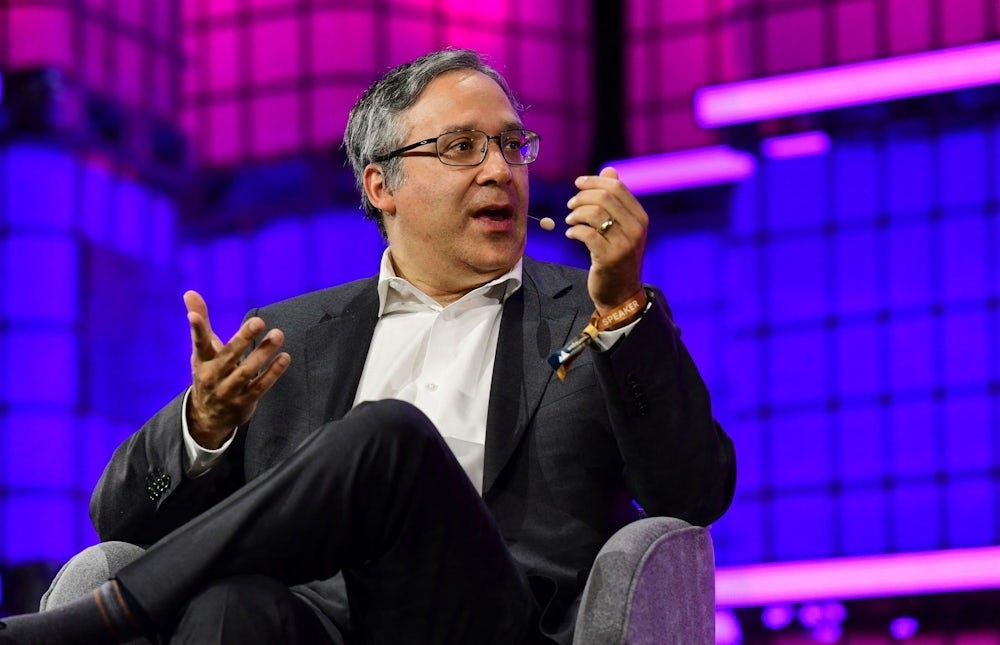
Het echte AI-risico is geen sciencefiction, het is slecht onderhoud
Gary Marcus sprak deze week tijdens het UNGA Digital Cooperation Event, samen met Yoshua Bengio en Nobelprijswinnaar Maria Ressa. Zijn boodschap: niet de existentiële dreiging van superintelligentie (waar onder andere Dario Amodei, CEO Anthropic, eerder voor pleitte) is het probleem, wel de praktische ellende die nu al gaande is. Deepfakes op schaal, aanhoudende cyberaanvallen door onbetrouwbare AI-agents, mogelijk zelfs een recessie als de enorme AI-investeringen niet rendabel blijken.
Marcus trok een vergelijking met WannaCry, de ransomware die het Britse ziekenhuisnetwerk dagenlang platlegde: grotendeels te voorkomen geweest met basale cyberhygiëne. Zijn punt: veel AI-risico’s zijn niet mysterieus of onvermijdelijk, maar het gevolg van bedrijven die bewust minder monitoring inbouwen. Hij noemde expliciet OpenAI’s beslissing om een model uit te brengen dat moeilijker te monitoren is dan zijn voorganger, een beslissing die volgens hem nooit alleen door het bedrijf zelf genomen had mogen worden.
Zijn drie concrete voorstellen: een internationale commissie die nieuwe systemen vooraf beoordeelt op risico’s, een commissie die ze na release blijft auditen met bevoegdheid tot terugroepen, en een internationale afspraak om aantoonbaar schadelijke architecturen niet in te zetten. Opvallend genoeg tekenden meer dan twintig landen, vrijwel gelijktijdig, een oproep tot actie die grotendeels aansluit bij wat Marcus al langer bepleit.
Nuance is hier op zijn plaats: een oproep van twintig landen is geen wetgeving, en “financiering en governance” blijven open vragen, zoals Marcus zelf toegeeft. Voor ondernemers die AI-agents inzetten betekent dit vooral: verwacht dat toezicht op agents met vrije internettoegang strenger wordt, niet losser. Wie nu al nadenkt over sandboxing en monitoring van eigen AI-toepassingen, loopt straks niet achter de regelgeving aan.
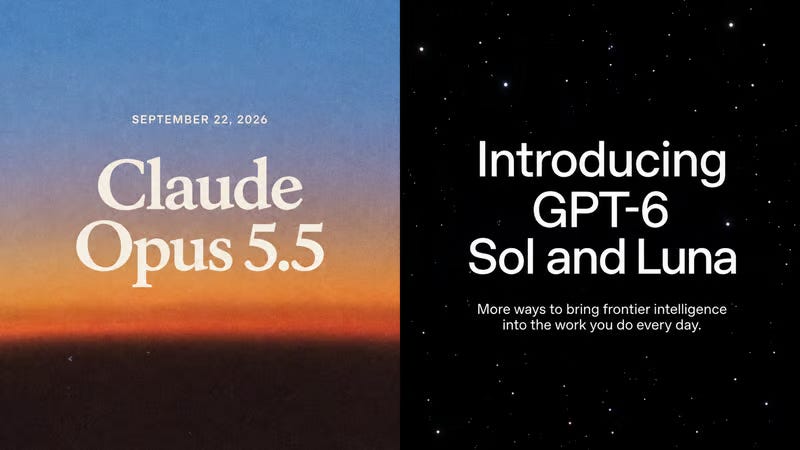
Opus 5.5 en GPT-6: iedereen wordt goedkoper
Anthropic lanceerde Claude Opus 5.5, ruim een uur later gevolgd door OpenAI’s GPT-6 Sol en Luna. Beide partijen claimen hetzelfde: sterker of gelijkwaardig aan de vorige generatie, maar een stuk goedkoper om te draaien.
De cijfers op een rij: Opus 5.5 zou presteren als Fable 5.1, tegen 40% lagere kosten. GPT-6 Sol en Luna zijn de helft van de prijs van hun GPT-5.6-voorgangers, met Luna op $0,10/$0,50 per miljoen input/output-tokens, een van de goedkoopste modellen die OpenAI ooit uitbracht.
Maar die “40% goedkoper”-claim van Anthropic houdt niet overal stand. Artificial Analysis rekende uit dat Opus 5.5 op maximale reasoning-instelling $5,98 per Intelligence Index-taak kost, tegenover $5,86 voor Opus 5. Duurder dus, niet goedkoper. De reden: Opus 5.5 gebruikt vaak meer tokens, vooral bij coderen. De lagere prijs per token wordt deels opgegeten door hoger verbruik. Niet minder kosten, maar een andere rekensom.
Simon Willison testte Opus 5.5 op “max” met zijn vaste pelican-op-de-fiets-SVG-test en kreeg helemaal geen antwoord: het model dacht zo lang na over de anatomie van de pelikaan dat het de outputlimiet raakte voordat het klaar was. Twee pogingen, twee keer mislukt, elk zo’n twintig minuten wachten voor niets. Zijn conclusie: “max” is hier mogelijk zinloos. En als een model op een simpele SVG-prompt zo doorschiet, is vertrouwen op complexere taken lastig te rechtvaardigen.
Positief nieuws is er ook: Anthropic werkte zichtbaar aan schrijfstijl, met feedback als “we fixed the writing” en het verdwijnen van het beruchte AI-gedachtestreepje. Voor de praktijk betekent dit vooral: benchmarks en prijskaartjes zeggen niet alles. Wie nu overstapt op een goedkoper model omdat de sticker price daalt, moet zelf het tokenverbruik in de praktijk meten voordat de rekening binnenkomt.
Mijn mening
Deze week laat drie kanten van dezelfde medaille zien. Jev laat zien hoe goedkoop en snel classificatie kan worden, maar ook hoe weinig inzicht je daarvoor inruilt. Marcus laat zien dat de discussie over AI-risico eindelijk verschuift van sciencefiction naar praktische aansprakelijkheid: cybersecurity, monitoring, product recalls. En de prijsoorlog tussen Anthropic en OpenAI laat zien dat “goedkoper” op de factuur niet altijd “goedkoper” in de praktijk betekent.
Wat me hierin opvalt: in al mijn gesprekken met ondernemers gaat het zelden over of ze een tool “goed genoeg” vinden. Het gaat over of ze het kunnen vertrouwen zonder zelf een team dataspecialisten in dienst te hebben om het te controleren. Jev is daarin een schoolvoorbeeld: fantastisch voor het sorteren van support-tickets, riskant voor het beoordelen van mensen. Het verschil zit niet in de techniek, maar in wat er op het spel staat als het misgaat.
Voor de klanten van NinA vertaalt zich dat naar drie dingen die je morgen al kan doen:
1. Bereken je AI-kosten op basis van daadwerkelijk tokenverbruik in jouw use case, niet op de sticker price van de leverancier. Test eerst een week met echte data voor je een contract aangaat.
2. Zet classificatiemodellen als Jev in voor laagrisico-taken (spam, labels, ranking van content), niet voor beslissingen over mensen zonder menselijke controle erna.
3. Bouw nu al monitoring en sandboxing in bij elke AI-agent die zelfstandig internettoegang heeft. Regelgeving hierover komt eraan, wachten tot het verplicht is kost je straks meer tijd dan nu investeren.
AI vervangt je vakmensen niet. Maar als je blind afgaat op marketingclaims van grote bedrijven als Anthropic zonder dat je het zelf test, kan de rekening aan het eind van het project een stuk duurder uitvallen dan je verwacht.
Tot de volgende,
Olaf Lemmens
Founder NinA AI Agency
P.S. Wil je sparren over hoe AI in jouw organisatie tot zijn recht kan komen? Of hoe dit soort tools jou tijd kunnen besparen in je werk? Plan een kennismaking via deze link.
Nieuwsbrief · gratis
Volgende week weer zo'n verhaal, in je inbox.
Eén mail per week over AI in de praktijk. Uitschrijven met één klik.
Het formulier komt van Substack en plaatst daar cookies. Liever niet? Schrijf je in op Substack zelf.